En este blog se exploran las posibilidades de analizar datos y crear modelos basados en la Teoría de la Información usando Powerhouse

viernes, 25 de febrero de 2011

La entropía como medida de la información

En el artículo anterior mostré cómo es posible medir la información que un grupo de variables lleva sobre otra y en el artículo sobre Información, incertidumbre y sorpresa expliqué cómo medir la información de una variable.


En este artículo mostraré cómo la entropía también es útil cuando medimos la información de un conjunto de variables.

Supongamos que tenemos dos tablas con 3 variables numéricas con similar distribución cada una (podemos asumir una distribución uniforme o normal).

Supongamos que la primer tabla, que llamaré T1, tiene las variables sin ningún tipo de relación entre ellas, mientras que la tabla T2 contiene algún tipo de relación entre las variables.

Voy a dejar algunas preguntas para que las responda el que lo desee y en breve publicaré las respuestas.

¿Qué tabla contiene más “orden”? ¿La T1 o la T2?

¿Cuál de las dos tablas tendrán una entropía mayor? ¿por qué?

¿Cómo debería ser el tipo de relación para que la entropía sea mínima o máxima?

Asumiendo que cada una de las tres variables lleva algo de información sobre una cuarta variable, ¿qué tabla es preferible para armar un modelo de predicción?

Quedo a la espera de respuestas y/o comentarios.

Gracias

miércoles, 12 de mayo de 2010

¿Cómo medir la información que lleva un grupo de variables?


Varias veces me preguntaron cómo es posible aplicar la Teoría de la Información de Shannon cuando existe más de una variable en juego. La respuesta es muy simple si hacemos una distinción entre variables y estados.

Para medir la información que genera una fuente Shannon propone utilizar la entropía definida como:

en donde pi representa la probabilidad de ocurrencia del estado i. La entropía se mide en bits.

Por ejemplo, si una fuente de información es capaz de generar 3 estados distintos con probabilidades 0.3, 0.5 y 0.2, entonces la entropía será:

H = 1.486 bits

El ejemplo anterior podría referirse a una variable que contenga 3 valores distintos, cuya distribución sea 0.3, 0.5 y 0.2. En este caso diríamos que esta variable contiene 1.486 bits de información.

La duda aparece cuando consideramos más de una variable. ¿Cómo podemos aplicar la misma ecuación?

La clave está en considerar los estados a los que se refiere el cálculo de la entropía no como valores de una variable, sino como puntos en un espacio n-dimensional. Cada variable representa una dimensión del espacio.

Cuando queremos analizar una tabla con datos que representan distintos casos (cada fila es un caso y cada columna es una variable que toma diferentes valores según los atributos del caso), podemos representarlos mediante un espacio cuya dimensión está dada por la cantidad de variables. Cada caso es un punto en el espacio. Casos similares estarán situados en una región próxima del espacio. Si los casos se refieren a clientes y las variables representan comportamientos, entonces el espacio representará los distintos comportamientos de los clientes mediante los puntos, o estados.

La información que contiene este espacio dependerá de cómo se sitúan estos puntos y puede medirse mediante la entropía, utilizando cada punto como un estado.

martes, 21 de abril de 2009

Selección de variables

Seleccionar las mejores variables puede llegar a ser uno de los principales problemas en un proyecto de Data Mining.

Una opción es elegir aquellas variables que desde el punto de vista del negocio parecen importantes. Claro que para esto se debe conocer muy bien el negocio y se puede correr el riesgo de elegir variables altamente correlacionadas. Además es muy posible que el grupo de variables seleccionadas diste mucho de ser el óptimo (por ejemplo, podrían quedar afuera ciertas variables que aportan buena información).

Otra alternativa es la fuerza bruta, pero sólo en casos con muy pocas variables disponibles. Cuando la cantidad de variables comienza a ser importante, este enfoque queda descartado debido a la enorme cantidad de pruebas que hay que realizar. Por ejemplo, suponiendo que hay 20 variables disponibles y se deben elegir 6, la cantidad de combinaciones posibles es mayor a 38.000. Si en vez de 20 tenemos 100, las diferentes combinaciones superan los 1.000 millones.

Un método que ha demostrado ser muy eficiente es el que se basa en la Teoría de la Información. Sin entrar en demasiados detalles, los pasos a seguir son los siguientes:
  1. Seleccionar del total de las variables, aquella que transmite mayor cantidad de información.
  2. Seleccionar del resto de variables disponibles, aquella que transmita la mayor cantidad de información nueva
  3. Continuar en el paso 2 hasta que la ganancia de información ya no justifique la pérdida de representatividad de población (ver artículo ¿Cuántos datos necesito para obtener un buen modelo?)

Este procedimiento toma muy poco tiempo y crea un conjunto de variables que cumple con las siguientes características:

  1. Contiene la mayor cantidad de información dado los datos disponibles
  2. Contiene la mejor relación señal/ruido
  3. Las variables seleccionadas no son colineales
  4. Tiene en cuenta las interacciones entre variables
  5. Usualmente aparecen seleccionadas variables que son consideradas como muy importantes desde el punto de vista del negocio

Aquellos interesados en conocer más acerca de la Teoría de la Información pueden leer el artículo Powerhouse: Data Mining usando Teoría de la Información

jueves, 2 de octubre de 2008

Correlación e Información Mutua

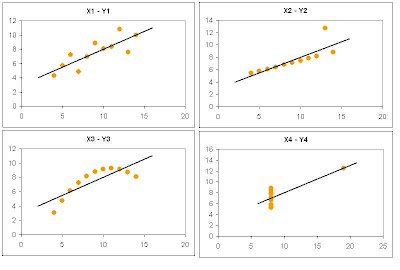
El coeficiente de correlación entre dos variables está basado en la covarianza (y normalizado mediante las varianzas de cada variable) y asume, entre otras cosas, que la relación entre las variables es lineal. Esto significa que el coeficiente de correlación (o de determinación r2) no es suficiente para saber si dos variables están correlacionadas. El siguiente es un ejemplo tomado del libro “The Visual Display of Quantitative Information” de Edward Tufte y basado en 4 pares de variables ideadas por Francis Anscombe.

Las 4 variables Y tienen la misma media y desviación estándar. Además el coeficiente de correlación entre X e Y es el mismo en los 4 casos (0.816) y comparten la misma recta de regresión y = 0.5 x + 3

Las cuatro relaciones con distintas entre si, pero sus correlaciones son las mismas. Esto nos enseña la importancia de usar gráficos de dispersión para visualizar la relación entre dos variables, más que confiar en su correlación.

¿Pero qué sucede si analizamos estas relaciones usando medidas de información?

La primera diferencia que encontramos es que las entropías de las variables Y son distintas, excepto las dos últimas. La diferencia más importante es que la información transmitida entre cada par de valores es diferente en los 4 casos, como puede verse en la siguiente tabla


En los tres primeros casos, la información transmitida nos indica que es posible realizar un buen modelo, mientras que en el último caso, un valor de sólo 18% nos dice que ningún modelo será capaz de hacer un buen trabajo para representar esta relación (lo cual es obvio mirando el gráfico de dispersión).

La información transmitida no asume ningún tipo de relación, como lo hace el coeficiente de correlación. Esta es una gran ventaja, porque muchos data sets contienen relaciones no-lineales que son descartadas al utilizar correlaciones lineales.

En casos que involucran sólo dos variables, una manera de confirmar si la relación es lineal es usar los gráficos de dispersión, pero cuando aparecen más variables independientes, graficar la relación no sirve. Una solución es utilizar medidas de información mutua como la información transmitida.

viernes, 25 de abril de 2008

Ya no es necesario torturar los datos

Existe un concepto muy arraigado y que se basa en las viejas tecnologías de análisis de datos: para obtener un buen modelo hay que hacer una enorme cantidad de pruebas.

¿Cuál es la mejor transformación para cada variable? ¿Cuál es el mejor valor para reemplazar los nulos? ¿Cuáles son las variables más adecuadas para realizar el modelo? ¿Cuántas variables se deben incluir? ¿Qué tipo de modelo es el mejor? Éstas son algunas de las tantas preguntas que se deben contestar para crear un modelo, con lo que no es de extrañar que muchos piensen que no sólo tienen que hacer muchos intentos sino que además deben saber de estadística y necesitan tener mucha experiencia.

Afortunadamente la teoría de la información responde a cada una de estas preguntas. La clave está en medir la información que contiene cada variable disponible. Hay sólo una transformación de la variable que maximiza la información y reduce el ruido. Existe sólo un grupo de variables que lleva la mayor información posible con el menor ruido posible.

Una vez realizada la mejor transformación y elegidas las mejores variables, toda la información disponible está expuesta de tal manera que con una simple regresión se obtiene un modelo excelente y muy fácil de interpretar.

En resumen, con la teoría de la información ya no es necesario ensayar diferentes transformaciones de variables, distintas combinaciones de variables y algoritmos para ver cuál es el que mejores resultados genera.

Hay un solo camino para hacer las cosas: el óptimo.

¿Utopía? No, realidad.

Powerhouse es la prueba.

viernes, 28 de marzo de 2008

Modelos de predicción usando modelos de segmentos

En el artículo anterior comenté que los modelos de clusters o segmentos pueden usarse para varios propósitos. Hoy mostraré cómo es posible usar un modelo de segmentos para predecir.

Powerhouse permite generar modelos de clusters con distintas cantidades de segmentos. Cuando se usa el modelo para explicar los datos, se prefieren pocos segmentos, pero si el modelo se usa para predecir, es preferible que la cantidad de segmentos o clusters sea grande.

Un modelo de clusters es normalmente un modelo no supervisado. Dicho de otro modo, no existe una variable output que sirve como guía en la creación del modelo. La utilidad de un modelo no supervisado está relacionada con la manera en que se distribuyen los valores de las variables en cada uno de los clusters.

Si los valores de la variable output (variable a predecir) se distribuyen con diferentes rangos en cada cluster, es posible usar el promedio de los valores de cada cluster como valor predicho. Por ejemplo, supongamos que un modelo contiene 10 clusters. Supongamos también que la variable a predecir es del tipo SI/NO. Si asignamos 1 para SI y 0 para NO, podemos calcular el promedio por cada cluster y cada valor representará la probabilidad de que la variable tome valor SI. La siguiente tabla muestra lo que podrían ser estos valores

Con esta tabla podemos armar el modelo de predicción de la siguiente manera: cuando tenemos un caso nuevo, representado por las mismas variables con las que se armó el modelo de cluster, sólo hay que calcular el cluster al que corresponde. Luego, la predicción, que en este ejemplo será la probabilidad de ser "SI", será la probabilidad asignada al cluster en la tabla de arriba.

Como ejemplo práctico usé datos acerca de los clientes de un banco para armar un modelo de riesgo crediticio. Luego construí un modelo de cluster, que en Powerhouse se llama OPTICL. Modifiqué la cantidad de clusters llevándolo al máximo. Esto resultó en un modelo con 64 clusters. Luego calculé la probabilidad de encontrar valores SI de la variable output usando los datos de entrenamiento.

Es importante aclarar que Powerhouse no usa la variable output para construir un modelo de cluster (si lo hiciera ya no sería un modelo no supervisado).

Finalmente apliqué el modelo en los datos de prueba (esto genera un número de cluster para cada caso) y reemplacé los números de cluster de cada caso por la probabilidad calculada anteriormente.

¿El resultado? Un modelo con un KS de 51% (es un excelente valor). Para comparar, realicé un modelo de predicción utilizando el Scorecard de Powerhouse sobre los mismos datos y encontré que el rendimiento fue levemente superior con un KS de 55% sobre los datos de prueba.

Conclusiones:

Los modelos de predicción no tienen que ser necesariamente supervisados. En este artículo vimos cómo es posible realizar un modelo no supervisado con una muy buena respuesta.

jueves, 27 de marzo de 2008

Segmentaciones con Powerhouse

Los modelos de clustering tienen varios usos, uno de los cuales es la segmentación de clientes.

Se pueden segmentar los clientes en base a diferentes criterios y utilizando distintas variables. Powerhouse tiene la capacidad de encontrar los segmentos naturales que puedan existir en los datos en forma completamente automática. Sólo es necesario indicarle cuáles serán las variables con las que deberá trabajar y elegir algunos de sus modelos.

Como ejemplo de segmentación elegí los datos provenientes de una línea de POS (cajas registradoras). Uno de los módulos de Powerhouse es capaz de leer cada ticket y en base a una serie de parámetros generar automáticamente los datos en el formato usado en cualquier proyecto de Data Mining. En este artículo mostraré unos pocos ejemplos de la información encontrada en la comparación de los clusters o segmentos.

La representación gráfica de los segmentos que muestra Powerhouse es la siguiente:


Los puntos negros representan los clientes. Cuando dos clientes son similares, o sea, los valores que toman todas las variables que los identifican son parecidos, aparecen juntos. Cuanto más se parezcan más juntos estarán. En cambio si dos clientes son muy distintos, ya no serán vecinos sino que estarán situados en zonas separadas.

Cuando la densidad de puntos es alta (o lo que es lo mismo, cuando en una zona se agrupen gran cantidad de clientes similares), el color de la zona es rojo. Cuando una zona tiene muy baja densidad, el color es azul. Los colores intermedios indican zonas con densidades intermedias.

Powerhouse busca las zonas de más baja densidad para delimitar los distintos segmentos. En el gráfico de arriba estos límites están representados por líneas blancas.

Basado en estos datos Powerhouse identificó 3 segmentos (este es el número de segmentos que mejor se ajusta, pero el usuario tiene la posibilidad de elegir un número distinto de segmentos).

Ahora es momento de encontrar qué características tiene cada segmento. O sea, en qué se parecen y en qué se distinguen los segmentos encontrados.

Una manera de hacerlo (y no es la única ofrecida por Powerhouse), es mediante la comparación de clusters que se genera automáticamente con un clic.

La ventana de Estadísticas de los Clusters nos permite ver cómo se distribuyen los valores de cada una de las variables entre los distintos segmentos. En este caso vemos que el monto promedio gastado en cada ticket es distinto en cada segmento. La columna que dice Todos indica cuál es el promedio, el valor mínimo y el máximo de esta variable considerando todos los clientes, en este caso 114,81$. El resto de las columnas indica también los valores promedios, mínimo y máximo pero para cada segmento. Abajo aparecen un pequeño gráfico de la distribución de estas variables.

Es posible hacer análisis similares para otras variables y encontrar el perfil de los clientes de cada segmento para luego tomar algún tipo de acción.

En este proyecto se encontraron muchas diferencias interesantes, por ejemplo una de ellas es que el segmento que deja el márgen bruto más alto también es el que compra pocos productos de indumentaria pero el que más gasta en frutas y verduras.